Stel een vraag over Nederland. Je AI maakt er een monitor van.
Databron leert je AI-assistent hoe je van open data een monitor maakt die klopt: de juiste bron, getoetste cijfers, een heldere grafiek, elke dag vers, en bij elk getal de bron.
Nederland meet meer dan ooit, en bijna alles daarvan is open. Toch bleef het meeste liggen: het vroeg tijd, kennis en vaak een heel team.
Met Open Data Index en Databron krijgt je eigen AI die kennis erbij. Zo onderzoek je de vraag die je je altijd al stelde, en begrijp je hem in één avond beter.
Elke regel een jaar, van 1951 tot en met 16 oktober 2026. Oranje: een week die minstens 2 graden warmer was dan normaal in De Bilt; grijs: minstens 2 graden kouder. In 1951–1960 waren er 365 zulke warme dagen, in 2016–2025 1.089.
Het probleem.
Een AI bouwt snel, maar data vergeeft niets
De stille nul
Een ontbrekende meting wordt 0. De grafiek zakt in, en niemand krijgt een foutmelding.
De verkeerde eenheid
Het KNMI meet in tienden van een graad. 147 is 14,7 °C, maar dat staat nergens in het antwoord.
Live van gisteren
Een site die ‘nu’ zegt bij cijfers van vorige maand, en die stilvalt als de bron hapert.
De oplossing.
Een gratis upgrade voor je AI
Databron is een set skills plus een koppeling met Open Data Index. Je installeert het één keer in Claude Code, Codex, Cursor, Copilot of Gemini CLI. Daarna werkt je AI volgens een vaste werkwijze: twaalf stappen, elk met een controle, en met de kennis van waar het bij elke bron misgaat.
Je eigen monitor, als website
Op jouw GitHub en jouw domein, op Vercel of Cloudflare. Meestal in de gratis laag.
Cijfers die kloppen
Een toets houdt publicatie tegen bij een gat, een rare sprong of een 0 waar niets hoort te staan.
Elke dag vers
GitHub haalt de nieuwe cijfers op. Valt de bron uit, dan blijft de laatste goede stand staan.
Bij elk getal de bron
De exacte aanroep, de licentie en de datum van de laatste meting. Iedereen kan het nagaan.
Grafieken die iets zeggen
De kop is de bevinding, labels staan aan de lijn, grijs is context. Snel en goed op een telefoon.
Vindbaar voor mensen en AI
Een deelbeeld per pagina, sitemap, JSON-LD en llms.txt, zodat assistenten je antwoord citeren.
Voor iedereen met een vraag
De journalist die een bewering wil checken.
Het raadslid dat een besluit wil begrijpen.
De buurtbewoner die wil weten of het echt drukker werd.
Of gewoon iemand die het wil weten.
Installeren.
Installeer in twee minuten
Kies je gereedschap. Je installeert Databron één keer; daarna werkt het in elk project.
Alles in één: de vijftien skills, het sjabloon voor je site, en de koppeling met Open Data Index.
Twee losse stappen in Claude Code, elk met Enter. Of in één keer in je terminal: claude plugin marketplace add lucashuizinga/databron-skill && claude plugin install databron@databron. De MCP-server van de Index koppelt vanzelf.
/databron Is het dit jaar warmer dan normaal in De Bilt?
Je vraag.
Stel je vraag, Databron maakt hem scherp
Vier soorten projecten, elk met een eigen opbouw. Kopieer er een, of kies uit de dertig projectideeën van Open Data Index. Jij zegt ja tegen de antwoordzin voordat er iets gebouwd wordt.
Doel of trendEén getal tegen een doel of normaal, elke dag.
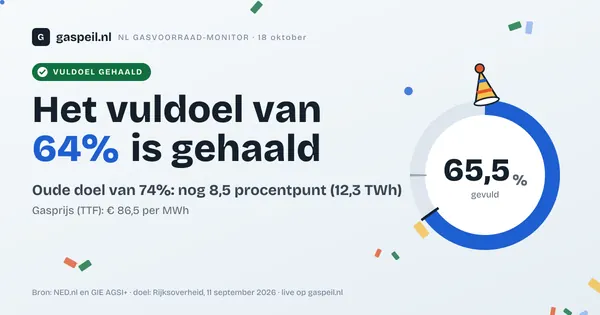
/databron Halen we dit jaar het vuldoel van de gasopslag?
AtlasElke plek een eigen pagina met een eigen bevinding.
/databron Hoe staat mijn gemeente ervoor op luchtkwaliteit en groen?
ProfielBronnen samen tot een herkenbaar beeld.
/databron Hoe ziet de doorsnee inwoner van mijn provincie eruit?
AuditWie publiceert wat, met bewijs bij elk oordeel.
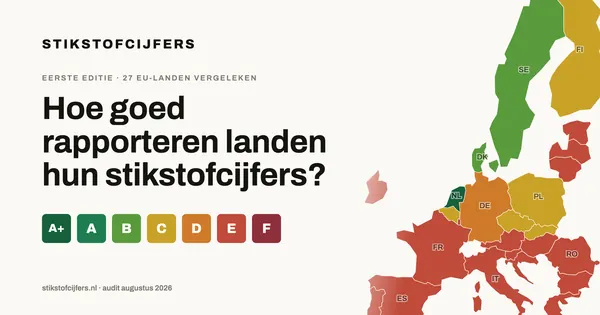
/databron Hoe goed publiceren gemeenten hun open data?
De controle.
Elke stap eindigt met een controle
Niet ‘ziet er goed uit’, maar een test die slaagt voordat de volgende stap begint. Open een stap om te zien wanneer hij klaar is.
0startEen repo uit het sjabloon, op GitHub, live op Vercel of Cloudflare.
Klaar als De live-URL toont de site met de antwoordzin, oogst.yml is één keer groen gedraaid, en STAND.md beschrijft de stand. Meld de gebruiker in twee zinnen wat er nu is en wat de volgende stap is.
1vraagDe kernvraag, en de antwoordzin die uit de cijfers moet volgen.
Klaar als Elke lege plek in de antwoordzin heeft een kandidaat-bron uit de Index (met id) of staat als open punt in STAND.md. Lees de antwoordzin hardop voor de gebruiker en vraag of dit de vraag is die ze beantwoord willen zien.
2verkenPer bron een getest datacontract: robots.txt, licentie, aanroep en valkuilen.
Klaar als Elke bron in bronnen.yaml heeft een geteste aanroep met datum en een kort voorbeeldantwoord in zijn contract, een licentie en een robots-afweging. Een bron die niet mag of niet werkt, staat erin met de reden, niet stil weggelaten.
3oogstOphalen met een waakhond die bij een storing de laatste goede stand houdt.
Klaar alspnpm oogst twee keer achter elkaar geeft hetzelfde resultaat (de tweede keer: niets veranderd). De parsertests slagen. Een gesimuleerde storing (zet de URL tijdelijk fout, of geef de parser een lege lijst) laat data/ op de vorige stand en zet een melding in data/run.json. Draai die proef echt en zet de uitkomst in STAND.md.
4opslagEen vaste indeling, als bestanden in git of in Neon of D1.
Klaar als Trede 1: git log -p data/ laat de wijzigingen per run zien en data/ klopt met de checksums. Trede 2: herstel uit de back-up in een lege database (of een Neon-branch) geeft op de site dezelfde cijfers; draai die proef echt.
5toetsDe poort vóór publicatie: een 0 waar niets hoort, een sprong, een gat.
Klaar alspnpm toets geeft exit 0. Bewijs één keer dat de poort werkt: maak een kopie van data/ met een geplante fout (een 0 waar null hoort, een sprong van 80%) en laat zien dat de toets faalt met een duidelijke zin. Herstel daarna.
6rekenAfgeleide cijfers als pure functies, elk met een test.
Klaar alspnpm test slaagt, en elke functie in lib/reken.ts heeft een test met een met de hand gecontroleerd getal.
7duidTekst uit cijfers, met vaste regels voor eenheid, periode en meervoud.
Klaar alstests/duid.test.ts draait de tekstlaag over alle entiteiten en periodes en vindt geen NaN, undefined, null, lege plekken ({), dubbele spaties, getallen zonder eenheid, verkeerde meervouden, of de woorden "nu", "momenteel", "deze maand", "live". Lees daarna drie zinnen hardop (de voorleestest) en verbeter wat stroef is.
8beeldGrafieken met de eigen engine: SVG op de server, tekst in de HTML.
Klaar als Schermafbeeldingen op 390 en 1280 px, licht en donker (Playwright; headless Chromium verbergt scrollbalken, dus meet overloop met document.documentElement.scrollWidth > clientWidth en per element). Bekijk ze zelf kritisch tegen references/smaak.md: niets uit "Niet doen", geen botsende labels, kop klopt met wat je ziet. Zet ze in docs/beeld/.
9siteServer-first, met deelbeeld, sitemap, JSON-LD en llms.txt.
Klaar alspnpm build && pnpm start draait zonder fouten in de browserconsole; de curl-test vindt de antwoordzin; sitemap, llms.txt en OG-beeld geven 200; schermafbeeldingen op 390 px tonen geen overloop.
10verversEen GitHub Action die ophaalt, toetst en publiceert, elke dag.
Klaar als Eén echte run met gh workflow run oogst.yml is groen, en een run met een kapotte bron (tijdelijk een foute URL via een workflow_dispatch-invoer) laat de vorige stand staan, commit niets, en zegt in het log en in data/run.json wat er misging.
11deelGevonden en geciteerd worden: JSON-LD, een lancering, meten zonder cookies.
Klaar als De schema-validator (validator.schema.org) geeft geen fouten op de homepage en op één entiteitpagina, en curl van de homepage toont antwoordzin, peildatum en bron. docs/lancering.md staat er, ingevuld uit het sjabloon: de drie haakjes, de lijst met plekken en het meetplan. De gebruiker heeft de pitch uitdrukkelijk goedgekeurd; stilte is geen akkoord. Wat er gemeten wordt, staat op de site.
✓reviewZes reviewers die alleen melden wat ze kunnen aanwijzen.
Klaar als Geen open P1 in docs/review/<datum>.md. Wat bewust blijft staan, staat er met reden als bewust, en in STAND.md.
✓leerElke valkuil wordt een les, en gaat terug naar de Index.
Klaar als De les staat als bestand met geldige frontmatter, de aanroep is opnieuw gecontroleerd (of de herkomst eerlijk aangepast), er staat een test, toetsregel, AGENTS-regel of reviewpunt die hem voortaan vangt (of de reden waarom niet), en een les over een bron of platform is gemeld met een id.
Het bewijs.
Eén dag, van aanroep tot antwoord
Het voorbeeld in elk nieuw project, met echte cijfers van het KNMI. Volg 16 oktober 2026 door de hele lus.
Claude Codejouw siteOpen Data Index verbonden
› /databron Is het dit jaar warmer dan normaal in De Bilt?
Bron gevonden in Open Data IndexKNMI daggegevens, station De Bilt
Valkuilen gelezenDe temperatuur staat in tienden van een graad
Cijfers opgehaald27.683 dagen, 1951 tot en met 16 oktober 2026
Toets geslaagdGeen gaten; dagen vanaf 17 september gemarkeerd als voorlopig
Zin geschreven, grafiek getekendUit de cijfers, niet verzonnen
Live gezetEen GitHub Action haalt elke ochtend de nieuwe dag op
Warmte in De Bilt
Is het dit jaar warmer dan normaal in De Bilt?
Ja: 2026 is tot en met 16 oktober 1,3 graden warmer dan het gemiddelde van 1991–2020 over dezelfde dagen.
−5°0°5°10°15°20°25°30°janjfebfmrtmaprameimjunjjuljaugasepsoktonovndecd2025normaal202616 okt: 12,8 °C
Bron: KNMI daggegevens, CC BY 4.0. Laatste meting 16 oktober 2026.
De aanroep
Getest en vastgelegd, met een eerlijke user-agent.
curl \
  -A "databron-sjabloon/0.1 (+https://www.opendataindex.nl)" \
  -d "stns=260&vars=TG&start=19510101&end=20261231&fmt=json" \
  https://www.daggegevens.knmi.nl/klimatologie/daggegevens
Ja: 2026 is tot en met 16 oktober 1,3 graden warmer dan het gemiddelde van 1991–2020 over dezelfde dagen.
Geen enkel jaar sinds 1951 was over dezelfde dagen zo warm.
2026 was op 178 van de 289 dagen warmer dan normaalTemperatuur in De Bilt per dag, als lopend gemiddelde over 7 dagen, in °C. De grijze vlakte is waar 8 van de 10 jaren uit 1991–2020 lagen.
−5°0°5°10°15°20°25°30°janjfebfmrtmaprameimjunjjuljaugasepsoktonovndecd2025normaal202616 okt: 12,8 °C
Bron: KNMI daggegevens, station 260 De Bilt, CC BY 4.0. De cijfers vanaf 17 september 2026 zijn voorlopig: het KNMI kan ze na controle nog aanpassen.
De kennis.
Wat de één leert, weet de volgende
Open Data Index beschrijft 104 bronnen over Nederland: wat erin zit, hoe je het ophaalt en waar het misgaat. Databron vraagt de lessen op voordat er een regel code staat. Vindt je AI iets nieuws, dan meldt hij het terug; na controle staat het in de Index. Sleutels en persoonsgegevens gaan nooit mee.
geef_lessen({ bron: "knmi-daggegevens" })
Node fetch stuurt Accept-Language *, en sommige API's weigeren dat
Wat we zagen
De OESO-API gaf HTTP 500 en het Nationaal Georegister HTTP 400. Met curl ging dezelfde aanroep goed.
Wat werkt
Stuur zelf een taal mee: Accept-Language: nl, en;q=0.8.
Gemeten op 16 oktober 2026. Een les voor alle platforms.
Updates.
Blijf op de hoogte van wat er bijkomt
Nieuwe versies, nieuwe skills en monitors die anderen met Databron bouwden. We mailen alleen als er echt iets nieuws is.
Vragen.
Wat mensen eerst willen weten
Moet ik kunnen programmeren?
Nee. Zeg aan het begin dat je veel uitleg wilt. Databron legt dan elke stap uit, doet één ding tegelijk en laat jou alleen de logins zelf typen. Je hebt wel een AI-assistent nodig die in een map kan werken: Claude Code, Codex, Cursor, Copilot of Gemini CLI.
Wat kost het?
Databron zelf is gratis. Je betaalt je AI-assistent. GitHub, Vercel en Cloudflare hebben gratis lagen waar de meeste projecten in passen.
Welke data kan ik gebruiken?
Alles wat open is. Open Data Index beschrijft 104 bronnen over Nederland, van CBS en KNMI tot RIVM, Rijkswaterstaat en gemeenten, met geteste aanroepen en valkuilen. Staat iets er niet in, dan verkent Databron het zelf, en respecteert het robots.txt en de licentie.
Van wie is de website?
Van jou. De code staat op jouw GitHub, de site op jouw hosting en eventueel jouw domein. Databron is alleen de werkwijze.
Wat als de bron verandert of uitvalt?
De dagelijkse ophaalronde heeft een waakhond en een toets. Klopt er iets niet, dan blijft de laatste goede stand online en zie je in GitHub wat er misging.
Wat is het verschil met Open Data Index?
Open Data Index zegt waar de data is en hoe die werkt. Databron zegt hoe je ermee bouwt. Databron gebruikt de Index als kennisbron, en wat jij leert gaat terug naar de Index.
Ik bouw open-datasites met AI: elk beantwoordt één vraag met cijfers die je kunt nagaan, en houdt zichzelf bij. Databron is de werkwijze erachter, zodat jij het ook kunt.